discover · compare · collections · requirements · contribute · feed · watching · stats · help with your tokens
luhengshiwo/LLMForEverybody · source
Snapshot 0 · 2026-11-04T12:47:27Z · Jupyter Notebook · Apache-2.0
Content fingerprint
e42b1ba9a5a1b7ae93a36739c6bab2968972b73f732522e5bade5958e0f780fdGitHub description at capture
每个人都能看懂的大模型知识分享,LLMs春/秋招大模型面试前必看,让你和面试官侃侃而谈
README at capture
<p align="center"> <img src="pic/common/pr/learnllm.png" alt="LearnLLM.AI" width="600"> </p> <p align="center"> <a href="https://mp.weixin.qq.com/s/cV6v7yGmwYa2WwNDZjLPiQ"><img src="pic/common/svg/wechat.svg" alt="微信公众号" height="20"></a> <a href="https://www.zhihu.com/people/luhengshiwo"><img src="pic/common/svg/zhihu.svg" alt="知乎" height="20"></a> <a href="https://blog.csdn.net/qq_25295605?spm=1011.2415.3001.5343"><img src="pic/common/svg/csdn.svg" alt="CSDN" height="20"></a> <a href="https://juejin.cn/user/3824524390049531"><img src="pic/common/svg/juejin.svg" alt="掘金" height="20"></a> </p> <p align="center"><strong>Learning LLM is all you need.</strong></p> <p align="center"> 中文 | <a href="README.en.md">English</a> | <a href="README.ru.md">Русский</a> </p> <p align="center"><strong>👉 点击 <a href="https://learnllm.ai?ref=github">LearnLLM.AI</a> | 学习大模型,从这里开始</strong></p> ## LearnLLM.AI 核心亮点 **精选大模型面试题库**:覆盖从基础到前沿的实战题目,助您高效备战求职,抓住职业机遇; **系统化论文研读**:从2017年Transformer奠基性论文出发,按清晰的知识体系梳理技术演进,适合不同基础的开发者循序渐进地深度提升; **精选实战课程**:围绕 AI Agent、RAG 知识库、大模型微调与 LLM 应用开发等核心方向,打磨成体系的中文实战课程,覆盖 LangChain、LlamaIndex、Dify、MCP 等主流工具链,配套项目代码与讲师答疑,支持按主题灵活拆分、按需选学,帮你由点及面搭建完整的大模型知识体系。👉 [浏览全部课程](https://learnllm.ai/courses?ref=github) **专属优惠码** 我们为Github用户准备了限时专属优惠码:***GITHUB50*** ,期待在 [LearnLLM.AI](https://learnllm.ai?ref=github) 与您继续同行,共同成长! **配套视频教程(持续更新中)**: 👉 点击这里 [bilibili](https://space.bilibili.com/37863979/lists?sid=7144646) 👉 点击这里 [YouTube](https://www.youtube.com/@learnllm-ai) *如有疑问,欢迎随时联系我们。* *Happy Learning!* *LearnLLM.AI 团队* --- ## LLM 精选论文 | 时间 | 论文 | 介绍 | 视频 | 开始学习 | | --- | --- | --- | --- | --- | | 2017-06-12 | [Transformer](https://arxiv.org/abs/1706.03762) | 提出自注意力与 Transformer 架构 | [<img src="https://learnllm.ai/video_cover/transformer.jpg" width="200">](https://www.bilibili.com/video/BV1YPrKBuEjk) | [](https://www.learnllm.ai/learning?milestone=transformer&ref=github) | | 2018-06-11 | [GPT-1](https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf) | 预训练 + 微调的生成式 Transformer | [<img src="https://learnllm.ai/video_cover/gpt1.jpg" width="200">](https://www.bilibili.com/video/BV1gW6QBFEG4) | [](https://www.learnllm.ai/learning?milestone=gpt1&ref=github) | | 2018-10-11 | [BERT](https://arxiv.org/abs/1810.04805) | 双向编码器:MLM + NSP | [<img src="https://learnllm.ai/video_cover/bert.jpg" width="200">](https://www.bilibili.com/video/BV1n2kFBgEJ5) | [](https://www.learnllm.ai/learning?milestone=bert&ref=github) | | 2019-02-14 | [GPT-2](https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf) | 大规模无监督文本生成 | [<img src="https://learnllm.ai/video_cover/gpt2.jpg" width="200">](https://www.bilibili.com/video/BV1VwkWBtEfe) | [](https://www.learnllm.ai/learning?milestone=gpt2&ref=github) | | 2019-10-23 | [T5](https://arxiv.org/abs/1910.10683) | 文本到文本统一框架 | [<img src="https://learnllm.ai/video_cover/t5.jpg" width="200">](https://www.bilibili.com/video/BV1fHBfBdEGY) | [](https://www.learnllm.ai/learning?milestone=t5&ref=github) | | 2020-05-28 | [GPT-3](https://arxiv.org/abs/2005.14165) | 大模型与少样本学习能力 | [<img src="https://learnllm.ai/video_cover/gpt3.jpg" width="200">](https://www.bilibili.com/video/BV14Z63ByEWV) | [](https://www.learnllm.ai/learning?milestone=gpt3&ref=github) | | 2020-10 | [ViT](https://arxiv.org/abs/2010.11929) | 将 Transformer 主干引入视觉领域 | [<img src="https://learnllm.ai/video_cover/ViT.jpg" width="200">](https://www.bilibili.com/video/BV1UYAuzaEHd/) | [](https://www.learnllm.ai/learning?milestone=vit&ref=github) | | 2021-02 | [ViLT](https://arxiv.org/abs/2102.03334) | 极简视觉语言预训练架构 | [<img src="https://learnllm.ai/video_cover/ViLT.jpg" width="200">](https://www.bilibili.com/video/BV1vgXDBAEzM) | [](https://www.learnllm.ai/learning?milestone=vilt&ref=github) | | 2021-02 | [CLIP](https://arxiv.org/abs/2103.00020) | 用自然语言监督实现零样本视觉学习 | [<img src="https://learnllm.ai/video_cover/CLIP.jpg" width="200">](https://www.bilibili.com/video/BV1wGDvBfEv6) | [](https://www.learnllm.ai/learning?milestone=clip&ref=github) | | 2021-02 | [DALL·E 1](https://arxiv.org/abs/2102.12092) | 自回归文本生成图像的开端 | [<img src="https://learnllm.ai/video_cover/DALLE1.jpg" width="200">](https://www.bilibili.com/video/BV1zPXDBTE3c) | [](https://www.learnllm.ai/learning?milestone=dalle-1&ref=github) | | 2021-07-07 | [CodeX](https://arxiv.org/abs/2107.03374) | 面向代码生成的 GPT 系列模型 | [<img src="https://learnllm.ai/video_cover/codex.jpg" width="200">](https://www.bilibili.com/video/BV1JC67BEE7b) | [](https://www.learnllm.ai/learning?milestone=codex&ref=github) | | 2021-12 | [Stable Diffusion](https://arxiv.org/abs/2112.10752) | 潜空间扩散模型推动文生图开源化 | [<img src="https://learnllm.ai/video_cover/Stable_Diffusion.jpg" width="200">](https://www.bilibili.com/video/BV1HGDvBfE6g) | [](https://www.learnllm.ai/learning?milestone=stable-diffusion&ref=github) | | 2022-02-08 | [AlphaCode](https://arxiv.org/abs/2203.07814) | 竞赛级代码生成系统 | [<img src="https://learnllm.ai/video_cover/alphacode.jpg" width="200">](https://www.bilibili.com/video/BV1KbFTz2E8p) | [](https://www.learnllm.ai/learning?milestone=alphacode&ref=github) | | 2022-03-04 | [InstructGPT](https://arxiv.org/abs/2203.02155) | 人类反馈对齐与指令微调 | [<img src="https://learnllm.ai/video_cover/instructgpt.jpg" width="200">](https://www.bilibili.com/video/BV1qVFFzCERD) | [](https://www.learnllm.ai/learning?milestone=instructgpt&ref=github) | | 2022-04 | [DALL·E 2](https://arxiv.org/abs/2204.06125) | 基于 CLIP Latents 的高保真文生图 | [<img src="https://learnllm.ai/video_cover/DALLE2.jpg" width="200">](https://www.bilibili.com/video/BV1wCDQBkEbx) | [](https://www.learnllm.ai/learning?milestone=dalle-2&ref=github) | | 2022-12 | [Whisper](https://arxiv.org/abs/2212.04356) | 大规模弱监督语音识别基础模型 | [<img src="https://learnllm.ai/video_cover/whisper.jpg" width="200">](https://www.bilibili.com/video/BV1FmRyBhE21) | [](https://www.learnllm.ai/learning?milestone=whisper&ref=github) | | 2023-02-27 | [LLaMA-1](https://arxiv.org/pdf/2302.13971) | 高效开源预训练基座模型 | [<img src="https://learnllm.ai/video_cover/llama-1.jpg" width="200">](https://www.bilibili.com/video/BV1PqNMzZEw2) | [](https://www.learnllm.ai/learning?milestone=llama1&ref=github) | | 2023-04 | [LLaVA](https://arxiv.org/abs/2304.08485) | 开源多模态指令微调的重要起点 | [<img src="https://learnllm.ai/video_cover/LLaVA.jpg" width="200">](https://www.bilibili.com/video/BV1c2DQB6EtH) | [](https://www.learnllm.ai/learning?milestone=llava&ref=github) | | 2023-07-18 | [LLaMA-2](https://arxiv.org/abs/2307.09288) | LLaMA 升级版,开放商用 | [<img src="https://learnllm.ai/video_cover/llama-2.jpg" width="200">](https://www.bilibili.com/video/BV1ckNMzsEXJ) | [](https://www.learnllm.ai/learning?milestone=llama2&ref=github) | | 2023-08 | [Qwen-VL](https://arxiv.org/abs/2308.12966) | 通义千问早期视觉语言基座模型 | [<img src="https://learnllm.ai/video_cover/Qwen-VL.jpg" width="200">](https://www.bilibili.com/video/BV1i2dZBaE9T) | [](https://www.learnllm.ai/learning?milestone=qwen-vl&ref=github) | | 2023-09-28 | [Qwen 1](https://arxiv.org/abs/2309.16609) | 通义千问第一代基座模型 | [<img src="https://learnllm.ai/video_cover/qwen1.jpg" width="200">](https://www.bilibili.com/video/BV1FdwtziE2M) | [](https://www.learnllm.ai/learning?milestone=qwen-1&ref=github) | | 2023-10-10 | [Mistral 7B](https://arxiv.org/abs/2310.06825) | 高效 7B 级开源模型 | [<img src="https://learnllm.ai/video_cover/mistral_7b.jpg" width="200">](https://www.bilibili.com/video/BV19uwbzdEjj) | [](https://www.learnllm.ai/learning?milestone=mistral-7b&ref=github) | | 2023-12 | [LVM](https://arxiv.org/abs/2312.00785) | 纯视觉自回归建模的大视觉模型路线 | [<img src="https://learnllm.ai/video_cover/LVM.jpg" width="200">](https://www.bilibili.com/video/BV1rzdZBTENn) | [](https://www.learnllm.ai/learning?milestone=lvm&ref=github) | | 2024-02 | [Mixtral 8x7B](https://arxiv.org/abs/2401.04088) | 开源稀疏 MoE 的代表作 | [<img src="https://learnllm.ai/video_cover/Mixtral_8x7B_.jpg" width="200">](https://www.bilibili.com/video/BV116AuzoEMk) | [](https://www.learnllm.ai/learning?milestone=mixtral-8x7b&ref=github) | | 2024-03 | [Gemma 1](https://arxiv.org/abs/2403.08295) | Google 轻量开源模型家族首作 | [<img src="https://learnllm.ai/video_cover/Gemma-1.jpg" width="200">](https://www.bilibili.com/video/BV12jR1B6EKB) | [](https://www.learnllm.ai/learning?milestone=gemma1&ref=github) | | 2024-05 | [DeepSeek-V2](https://arxiv.org/abs/2405.04434) | 高效 MoE 语言模型,兼顾性能与推理经济性 | [<img src="https://learnllm.ai/video_cover/deepseek-V2.jpg" width="200">](https://www.bilibili.com/video/BV1gGZFBtEnB) | [](https://www.learnllm.ai/learning?milestone=deepseek-v2&ref=github) | | 2024-06 | [ChatGLM](https://arxiv.org/abs/2406.12793) | 从 GLM-130B 演进到 GLM-4 的国产模型家族 | [<img src="https://learnllm.ai/video_cover/ChatGLM.jpg" width="200">](https://www.bilibili.com/video/BV1yh5t6dEvG) | [](https://www.learnllm.ai/learning?milestone=chatglm&ref=github) | | 2024-07 | [Llama 3](https://arxiv.org/abs/2407.21783) | Meta 新一代开源旗舰模型 | [<img src="https://learnllm.ai/video_cover/LLaMA-3.jpg" width="200">](https://www.bilibili.com/video/BV1x85t64Exx) | [](https://www.learnllm.ai/learning?milestone=llama3-1&ref=github) | | 2024-07 | [Gemma 2](https://arxiv.org/abs/2408.00118) | 在实用尺寸上继续提升开源模型性能 | [<img src="https://learnllm.ai/video_cover/Gemma-2.jpg" width="200">](https://www.bilibili.com/video/BV1F2LP6pEi8) | [](https://www.learnllm.ai/learning?milestone=gemma2&ref=github) | | 2024-12 | [DeepSeek-V3](https://arxiv.org/abs/2412.19437) | 高效 MoE 架构,兼顾训练成本与模型性能 | [<img src="https://learnllm.ai/video_cover/deepseek-V3.jpg" width="200">](https://www.bilibili.com/video/BV1d5LP6VER4) | [](https://www.learnllm.ai/learning?milestone=deepseek-v3&ref=github) | | 2025-01 | [DeepSeek-R1](https://arxiv.org/abs/2501.12948) | 通过强化学习增强大模型推理能力 | [<img src="https://learnllm.ai/video_cover/deepseek-R1.jpg" width="200">](https://www.bilibili.com/video/BV1f5VN6LEBB) | [](https://www.learnllm.ai/learning?milestone=deepseek-r1&ref=github) | | 2025-03 | [Gemma 3](https://arxiv.org/abs/2503.19786) | 原生多模态与 128K 长上下文的 Gemma | | [](https://www.learnllm.ai/learning?milestone=gemma3&ref=github) | 持续更新中... <details open> <summary>点击展开/收起</summary> <img src="pic/paper_roadmap.png" alt="roadmap" /> </details> ## AGI 之路 <details open> <summary>点击展开/收起</summary> ### 目录 - 🐳[序-AGI之路](#序-AGI之路) - 🐱[第一章-大模型之Pre-Training](#第一章-大模型之Pre-Training) - 🐼[架构](#架构) - 🐹[Optimizer](#Optimizer) - 🐰[激活函数](#激活函数) - 🐭[Attention](#Attention机制) - 🐯[位置编码](#位置编码) - 🐨[Tokenizer](#Tokenizer) - 🐻[并行策略](#并行策略) - 🐷[大模型训练框架](#大模型训练框架) - 🐶[第二章-大模型之部署与推理](#第二章-大模型之部署与推理) - 🐯[第三章-大模型微调](#第三章-大模型微调) - 🐻[第四章-大模型量化](#第四章-大模型量化) - 🐼[第五章-显卡与大模型并行](#第五章-显卡与大模型并行) - 🐨[第六章-Prompt-Engineering](#第六章-Prompt-Engineering) - 🦁[第七章-Agent](#第七章-Agent) - 🐷[RAG](#RAG) - 🐘[第八章-大模型企业落地](#第八章-大模型企业落地) - 🐰[第九章-大模型评估指标](#第九章-大模型评估指标) - 🐷[第十章-热点](#第十章-热点) - 🦁[第十一章-数学](#第十一章-数学) ### 序-AGI之路 **[⬆ 一键返回目录](#目录)** #### 大模型年度论文总结 [2017:Transformer 出现,一切从这里开始](00-序-AGI之路/大模型年度论文总结/2017.md) [2018:GPT 和 BERT,预训练开始分成两条线](00-序-AGI之路/大模型年度论文总结/2018.md) [2019:模型开始变大,GPT-2 和 T5](00-序-AGI之路/大模型年度论文总结/2019.md) [2020:GPT-3 来了,1750 亿参数到底带来了什么](00-序-AGI之路/大模型年度论文总结/2020.md) [2021:不只是文本,CLIP 让模型开始看图](00-序-AGI之路/大模型年度论文总结/2021.md) [2022:让模型更听话,InstructGPT 和 RLHF](00-序-AGI之路/大模型年度论文总结/2022.md) [2023:LLaMA 放出来之后,开源模型开始追上来](00-序-AGI之路/大模型年度论文总结/2023.md) [2024:开源模型开始重新算训练和推理这笔账](00-序-AGI之路/大模型年度论文总结/2024.md) [大家都在谈的Scaling_Law是什么](00-序-AGI之路/大家都在谈的ScalingLaw是什么.md) [智能涌现和AGI的起源](00-序-AGI之路/智能涌现和AGI的起源.md) [什么是perplexity](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247483766&idx=1&sn=56563281557b6f58feacb935eb6a872a&chksm=c2048544f5730c52cf2bf4c9ed60ac0a21793bacdddc4d63b481d4aa887bc6a838fecf0b6cc7&token=607452854&lang=zh_CN#rd) [Pre-Training预训练Llama-3.1 405B超大杯,需要多少算力资源?](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247483839&idx=1&sn=3f35dfe8ed2c87bf4c0b4ac7bfa3e6a9&chksm=c204858df5730c9b8a152a0330dee0183467a063c25aadd0da7cc47d9d5b2f97347fab22708d&token=607452854&lang=zh_CN#rd) ### 第一章-大模型之Pre-Training **[⬆ 一键返回目录](#目录)** #### 架构 [10分钟搞清楚为什么Transformer中使用LayerNorm而不是BatchNorm](01-第一章-预训练/10分钟搞清楚为什么Transformer中使用LayerNorm而不是BatchNorm.md) [混合专家模型MoE详解节选](01-第一章-预训练/混合专家模型MoE详解节选.md) [最简单的方式理解Mamba(中文翻译)](01-第一章-预训练/最简单的方式理解Mamba(中文翻译).md) [10分钟了解什么是多模态大模型](01-第一章-预训练/10分钟了解什么是多模态大模型.md) #### Optimizer [全网最全的神经网络优化器optimizer总结](01-第一章-预训练/全网最全的神经网络优化器optimizer总结.md) [神经网络的优化器(一)综述](01-第一章-预训练/神经网络的优化器(一)概述.md) [神经网络的优化器(二)SGD](01-第一章-预训练/神经网络的优化器(二)SGD.md) [神经网络的优化器(三)Momentum](01-第一章-预训练/神经网络的优化器(三)Momentum.md) [神经网络的优化器(四)ASGD](01-第一章-预训练/神经网络的优化器(四)ASGD.md) [神经网络的优化器(五)Rprop](01-第一章-预训练/神经网络的优化器(五)Rprop.md) [神经网络的优化器(六)AdaGrad](01-第一章-预训练/神经网络的优化器(六)AdaGrad.md) [神经网络的优化器(七)AdaDeleta](01-第一章-预训练/神经网络的优化器(七)AdaDeleta.md) [神经网络的优化器(八)RMSprop](01-第一章-预训练/神经网络的优化器(八)RMSprop.md) [神经网络的优化器(九)Adam](01-第一章-预训练/神经网络的优化器(九)Adam.md) [神经网络的优化器(十)Nadam](01-第一章-预训练/神经网络的优化器(十)Nadam.md) [神经网络的优化器(十一)AdamW](01-第一章-预训练/神经网络的优化器(十一)AdamW.md) [神经网络的优化器(十二)RAdam](01-第一章-预训练/神经网络的优化器(十二)RAdam.md) #### 激活函数 [为什么大型语言模型都在使用SwiGLU作为激活函数?](01-第一章-预训练/为什么大型语言模型都在使用SwiGLU作为激活函数?.md) [神经网络的激活函数(一)概述](01-第一章-预训练/神经网络的激活函数(一)概述.md) [神经网络的激活函数(二)Sigmiod、Softmax和Tanh](01-第一章-预训练/神经网络的激活函数(二)Sigmiod、Softmax和Tanh.md) [神经网络的激活函数(三)ReLU和它的变种](01-第一章-预训练/神经网络的激活函数(三)ReLU和它的变种.md) [神经网络的激活函数(四)ELU和它的变种SELU](01-第一章-预训练/神经网络的激活函数(四)ELU和它的变种SELU.md) [神经网络的激活函数(五)门控系列-GLU、Swish和SwiGLU](01-第一章-预训练/神经网络的激活函数(五)门控系列-GLU、Swish和SwiGLU.md) [神经网络的激活函数(六)GELU和Mish](<01-第一章-预训练/神经网络的激活函数(六)GELU和Mish.md>) #### Attention机制 [看懂FlashAttention需要的数学储备是?高考数学最后一道大题](01-第一章-预训练/看懂FlashAttention需要的数学储备是?高考数学最后一道大题!.md) [FlashAttentionv2相比于v1有哪些更新?](<01-第一章-预训练/FlashAttentionv2相比于v1有哪些更新?.md>) [为什么会发展出Multi-Query-Attention和Group-Query-Attention](<01-第一章-预训练/为什么会发展出Multi-Query-Attention和Group-Query-Attention.md>) [一文了解Deepseek系列中的MLA技术](01-第一章-预训练/一文了解Deepseek系列中的MLA技术.md) #### 位置编码 [什么是大模型的位置编码Position-Encoding](<01-第一章-预训练/什么是大模型的位置编码Position-Encoding.md>) [复变函数在大模型位置编码中的应用](01-第一章-预训练/复变函数在大模型位置编码中的应用.md) [最美的数学公式-欧拉公式](01-第一章-预训练/最美的数学公式-欧拉公式.md) [从欧拉公式的美到旋转位置编码RoPE](01-第一章-预训练/从欧拉公式的美到旋转位置编码RoPE.md) #### Tokenizer [全网最全的大模型分词器(Tokenizer)总结](01-第一章-预训练/全网最全的大模型分词器(Tokenizer)总结.md) [搞懂大模型的分词器(一)](01-第一章-预训练/搞懂大模型的分词器(一).md) [搞懂大模型的分词器(二)](01-第一章-预训练/搞懂大模型的分词器(二).md) [搞懂大模型的分词器(三)](01-第一章-预训练/搞懂大模型的分词器(三).md) [搞懂大模型的分词器(四)](01-第一章-预训练/搞懂大模型的分词器(四).md) [搞懂大模型的分词器(五)](01-第一章-预训练/搞懂大模型的分词器(五).md) [搞懂大模型的分词器(六)](01-第一章-预训练/搞懂大模型的分词器(六).md) #### 并行策略 [大模型并行策略[中文翻译]](01-第一章-预训练/大模型并行策略[中文翻译].md) [大模型分布式训练并行技术(一)概述](01-第一章-预训练/大模型分布式训练并行技术(一)概述.md) [大模型分布式训练并行技术(二)数据并行](01-第一章-预训练/大模型分布式训练并行技术(二)数据并行.md) [大模型分布式训练并行技术(三)流水线并行](01-第一章-预训练/大模型分布式训练并行技术(三)流水线并行.md) [大模型分布式训练并行技术(四)张量并行](01-第一章-预训练/大模型分布式训练并行技术(四)张量并行.md) [大模型分布式训练并行技术(五)混合并行](01-第一章-预训练/大模型分布式训练并行技术(五)混合并行.md) #### 大模型训练框架 [大模型训练框架(一)综述](01-第一章-预训练/大模型训练框架(一)综述.md) [大模型训练框架(二)FSDP](01-第一章-预训练/大模型训练框架(二)FSDP.md) [大模型训练框架(三)DeepSpeed](01-第一章-预训练/大模型训练框架(三)DeepSpeed.md) [大模型训练框架(四)Megatron-LM](01-第一章-预训练/大模型训练框架(四)Megatron-LM.md) [大模型训练框架(五)Accelerate](01-第一章-预训练/大模型训练框架(五)Accelerate.md) ### 第二章-大模型之部署与推理 **[⬆ 一键返回目录](#目录)** [10分钟私有化部署大模型到本地](02-第二章-部署与推理/10分钟私有化部署大模型到本地.md) [模型部署不求人!从TTFT到Throughput的性能估算终极公式](02-第二章-部署与推理/模型部署不求人!从TTFT到Throughput的性能估算终极公式.md) [大模型output-token为什么比input-token贵](<02-第二章-部署与推理/大模型output-token为什么比input-token贵?.md>) [如何评判大模型的输出速度?首Token延迟和其余Token延迟有什么不同?](02-第二章-部署与推理/如何评判大模型的输出速度?首Token延迟和其余Token延迟有什么不同?.md) [大模型的latency(延迟)和throughput(吞吐量)有什么区别](02-第二章-部署与推理/大模型的latency(延迟)和throughput(吞吐量)有什么区别.md) [vLLM使用PagedAttention轻松、快速且廉价地提供LLM服务(中文版翻译)](<02-第二章-部署与推理/vLLM使用PagedAttention轻松、快速且廉价地提供LLM服务(中文版翻译).md>) [DevOps,AIOps,MLOps,LLMOps,这些Ops都是什么?](<02-第二章-部署与推理/DevOps,AIOps,MLOps,LLMOps,这些Ops都是什么?.md>) [大模型推理框架(一)综述](02-第二章-部署与推理/大模型推理框架(一)综述.md) [大模型推理框架(二)vLLM](02-第二章-部署与推理/大模型推理框架(二)vLLM.md) [大模型推理框架(三)Text generation inference (TGI)](<02-第二章-部署与推理/大模型推理框架(三)Text generation inference (TGI).md>) [大模型推理框架(四)TensorRT-LLM](02-第二章-部署与推理/大模型推理框架(四)TensorRT-LLM.md) [大模型推理框架(五)Ollama](02-第二章-部署与推理/大模型推理框架(五)Ollama.md) ### 第三章-大模型微调 **[⬆ 一键返回目录](#目录)** [10分钟教你套壳(不是)Llama-3,小白也能上手](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247483895&idx=1&sn=72e9ca9874aeb4fd51a076c14341242f&chksm=c20485c5f5730cd38f43cf32cc851ade15286d5bd14c8107906449f8c52db9d3bfd72cfc40c8&token=607452854&lang=zh_CN#rd) [大模型的参数高效微调(PEFT),LoRA微调以及其它](03-第三章-微调/大模型的参数高效微调(PEFT),LoRA微调以及其它.md) [大模型微调之Soft prompts(一)概述](<03-第三章-微调/大模型微调之Soft prompts(一)概述.md>) [大模型微调之Soft prompts(二)Prompt Tuning](<03-第三章-微调/大模型微调之Soft prompts(二)Prompt Tuning.md>) [大模型微调之Soft prompts(三)Prefix-Tuning](<03-第三章-微调/大模型微调之Soft prompts(三)Prefix-Tuning.md>) [大模型微调之Soft prompts(四)P-Tuning](<03-第三章-微调/大模型微调之Soft prompts(四)P-Tuning.md>) [大模型微调之Soft prompts(五)Multitask prompt tuning](<03-第三章-微调/大模型微调之Soft prompts(五)Multitask prompt tuning.md>) [大模型微调之Adapters(一)概述](03-第三章-微调/大模型微调之Adapters(一)概述.md) [大模型微调之Adapters(二)LoRA](03-第三章-微调/大模型微调之Adapters(二)LoRA.md) [大模型微调之Adapters(三)QLoRA](03-第三章-微调/大模型微调之Adapters(三)QLoRA.md) [大模型微调之Adapters(四)AdaLoRA](03-第三章-微调/大模型微调之Adapters(四)AdaLoRA.md) [大模型微调框架(一)综述](03-第三章-微调/大模型微调框架(一)综述.md) [大模型微调框架(二)Huggingface-PEFT](03-第三章-微调/大模型微调框架(二)Huggingface-PEFT.md) [大模型微调框架(三)Llama-Factory](03-第三章-微调/大模型微调框架(三)LLama-Factory.md) ### 第四章-大模型量化 **[⬆ 一键返回目录](#目录)** [10分钟理解大模型的量化](04-第四章-量化/10分钟理解大模型的量化.md) [大模型量化认知的三重境界](04-第四章-量化/大模型量化认知的三重境界.md) ### 第五章-显卡与大模型并行 **[⬆ 一键返回目录](#目录)** [AGI时代人人都可以看懂的显卡知识](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247484001&idx=1&sn=5a178a9006cc308f2e84b5a0db6994ff&chksm=c2048653f5730f45b3b08af03023aee24969d89ad5586e4e25c68b09393bf5a8abfd9670a6f3&token=607452854&lang=zh_CN#rd) [Transformer架构的GPU并行和之前的NLP算法有什么不同?](05-第五章-显卡与并行/Transformer架构的GPU并行和之前的NLP算法有什么不同?.md) [大模型部署三要素:显存、计算与通信深度解析](05-第五章-显卡与并行/大模型部署三要素:显存、计算与通信深度解析.md) ### 第六章-Prompt-Engineering **[⬆ 一键返回目录](#目录)** [过去式就能越狱大模型?一文了解大模型安全攻防战](<06-第六章-Prompt Engineering/过去式就能越狱大模型?一文了解大模型安全攻防战.md>) [万字长文Prompt-Engineering-解锁大模型的力量](<06-第六章-Prompt Engineering/万字长文Prompt-Engineering-解锁大模型的力量.md>) [COT思维链,TOT思维树,GOT思维图,这些都是什么](<06-第六章-Prompt Engineering/COT思维链,TOT思维树,GOT思维图,这些都是什么.md>) ### 第七章-Agent **[⬆ 一键返回目录](#目录)** [如何设计智能体架构:参考OpenAI还是Anthropic?](07-第七章-Agent/如何设计智能体架构:参考OpenAI还是Anthropic.md) [MCP:基础概念、快速应用和背后原理](07-第七章-Agent/MCP:基础概念、快速应用和背后原理.md) [LLM应用落地指南之应用的分类(一)](07-第七章-Agent/LLM应用落地指南之应用的分类(一).md) [LLM应用落地之架构设计(二)](07-第七章-Agent/LLM应用落地之架构设计(二).md) [LLM应用落地之Text-2-SQL(三)](07-第七章-Agent/LLM应用落地之Text-2-SQL(三).md) [开发大模型or使用大模型](07-第七章-Agent/开发大模型or使用大模型.md) [Agent设计范式与常见框架](07-第七章-Agent/Agent设计范式与常见框架.md) [langchain向左coze向右](07-第七章-Agent/langchain向左coze向右.md) [什么是沙箱:概念与三种实现方式](<07-第七章-Agent/什么是沙箱:概念与三种实现方式.md>) #### RAG [向量数据库拥抱大模型](07-第七章-Agent/向量数据库拥抱大模型.md) [搭配Knowledge-Graph的RAG架构](<07-第七章-Agent/搭配Knowledge-Graph的RAG架构.md>) [GraphRAG:解锁大模型对叙述性私人数据的检索能力(中文翻译)](<07-第七章-Agent/GraphRAG解锁大模型对叙述性私人数据的检索能力(中文翻译).md>) [干货:落地企业级RAG的实践指南](<07-第七章-Agent/干货-落地企业级RAG的实践指南.md>) [10分钟了解如何进行多模态RAG](07-第七章-Agent/10分钟了解如何进行多模态RAG.md) ### 第八章-大模型企业落地 **[⬆ 一键返回目录](#目录)** [CRUD-ETL工程师的末日从NL2SQL到ChatBI](08-第八章-大模型企业落地/CRUDETL工程师的末日从NL2SQL到ChatBI.md) [大模型落地难点之幻觉](08-第八章-大模型企业落地/大模型落地难点之幻觉.md) [大模型落地难点之输出的不确定性](08-第八章-大模型企业落地/大模型落地难点之输出的不确定性.md) [大模型落地难点之结构化输出](08-第八章-大模型企业落地/大模型落地难点之结构化输出.md) [大模型应用涌现出的新工作机会-红队测试Red-teaming](08-第八章-大模型企业落地/大模型应用涌现出的新工作机会-红队测试Red-teaming.md) [大模型复读机问题](08-第八章-大模型企业落地/大模型复读机问题.md) ### 第九章-大模型评估指标 [大模型有哪些评估指标?](09-第九章-评估指标/大模型有哪些评估指标?.md) [大模型性能评测之大海捞针(Needle In A Haystack)](09-第九章-评估指标/大模型性能评测之大海捞针.md) [评估指标/大模型性能评测之数星星](09-第九章-评估指标/大模型性能评测之数星星.md) ### 第十章-热点 **[⬆ 一键返回目录](#目录)** [Llama 3.1 405B 为什么这么大?](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247483782&idx=1&sn=3a14a0cde14eb6643beaeb5b472ffa26&chksm=c20485b4f5730ca2d7b002a29e617a75c08d004a1b3da891ab352cbe31ca37541a546e29abc7&token=607452854&lang=zh_CN#rd) [9.11大于9.9?大模型怎么又翻车了?](https://mp.weixin.qq.com/s?__biz=MzkyOTY4Mjc4MQ==&mid=2247483800&idx=1&sn=48b326352c37d686f7f46ee5df9f00b4&chksm=c20485aaf5730cbca8f0dfcb9746830229b8f07eec092e0e124bc558d1073ee32e3f55716221&token=607452854&lang=zh_CN#rd) [韩国“N 号房”事件因Deep Fake再现,探究背后的技术和应对方法](<10-第十章-热点/韩国“N 号房”事件因Deep-Fake再现,探究背后的技术和应对方法.md>) [我是怎么通过2022下半年软考高级:系统架构设计师考试的](10-第十章-热点/我是怎么通过2022下半年软考高级:系统架构设计师考试的.md) [用Exploit and Explore解决不知道吃什么的选择困难症](<10-第十章-热点/用Exploit-and-Explore解决不知道吃什么的选择困难症.md>) ### 第十一章-数学 **[⬆ 一键返回目录](#目录)** #### 线性代数 [0基础学习AI大模型必备数学知识之线性代数(一)](11-第十一章-数学/linear-algebra/0基础学习AI大模型必备数学知识之线性代数(一).md) [0基础学习AI大模型必备数学知识之线性代数(二)](11-第十一章-数学/linear-algebra/0基础学习AI大模型必备数学知识之线性代数(二).md) [0基础学习AI大模型必备数学知识之线性代数(三)](11-第十一章-数学/linear-algebra/0基础学习AI大模型必备数学知识之线性代数(三).md) #### 微积分 [0基础学习AI大模型必备数学知识之微积分(一)](11-第十一章-数学/calculus/0基础学习AI大模型必备数学知识之微积分(一).md) [0基础学习AI大模型必备数学知识之微积分(二)](11-第十一章-数学/calculus/0基础学习AI大模型必备数学知识之微积分(二).md) #### 概率统计 [0基础学习AI大模型必备数学知识之概率统计(一)贝叶斯定理和概率分布](11-第十一章-数学/Probability&Statistics/0基础学习AI大模型必备数学知识之概率统计(一)贝叶斯定理和概率分布.md) [0基础学习AI大模型必备数学知识之概率统计(二)概率分布的描述方法](11-第十一章-数学/Probability&Statistics/0基础学习AI大模型必备数学知识之概率统计(二)概率分布的描述方法.md) [0基础学习AI大模型必备数学知识之概率统计(三)中心极限定理](11-第十一章-数学/Probability&Statistics/0基础学习AI大模型必备数学知识之概率统计(三)中心极限定理.md) </details> --- ## 🌐 点击 [LearnLLM.AI](https://learnllm.ai?ref=github) | 学习大模型,从这里开始 [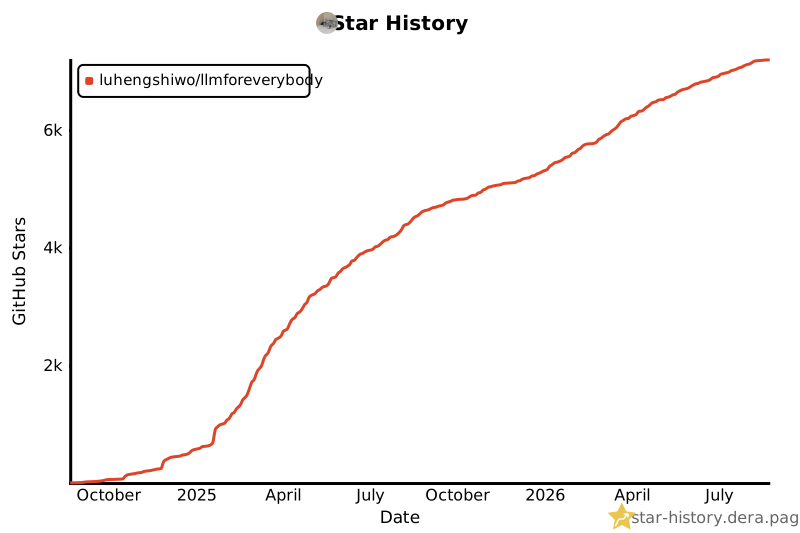](https://star-history.dera.page/#luhengshiwo/LLMForEverybody&Date)